Kako je implementirana dugoročna memorija Claude Code-a?
Kako je implementirana dugoročna memorija Claude Code-a?
Da li želite da znate kako je implementirana dugoročna memorija Claude Code-a?
Ne želite? O ne, želite, morate da želite. 😄
Za AI, kratkoročna memorija je kao podaci u RAM-u računara — kad se ugasi, nestanu. A onda ti, pametni, sigurno pomislite: dugoročna memorija nije valjda sačuvana u fajlovima na disku, pa da se automatski učita svaki put kad otvorite Claude Code?
I jeste.
Pa kako tačno Claude Code to radi? Gde se fajlovi čuvaju? Kako izgledaju? Kako se učitavaju?
Sam sam proučavao source code Claude Code-a i od nule, sopstvenim rukama, ispekao jedan terminal Agent pod imenom PaiCLI, koji je open-source na GitHub-u, tako da mogu samopouzdano, slobodno i otvoreno da ti pomognem da razumete ove tri stvari:
- Gde se čuva dugoročna memorija i kako izgleda?
- Kako se memorija pamti?
- Kad sledeći put otvorite novi razgovor, kako se memorija ponovo učita?
Danas za 3 minuta da vam jasno objasnim kako je implementirana dugoročna memorija Claude Code-a.
Veži pojas, polazimo!
Prvo, prva stvar — gde se čuva dugoročna memorija i kako izgleda.
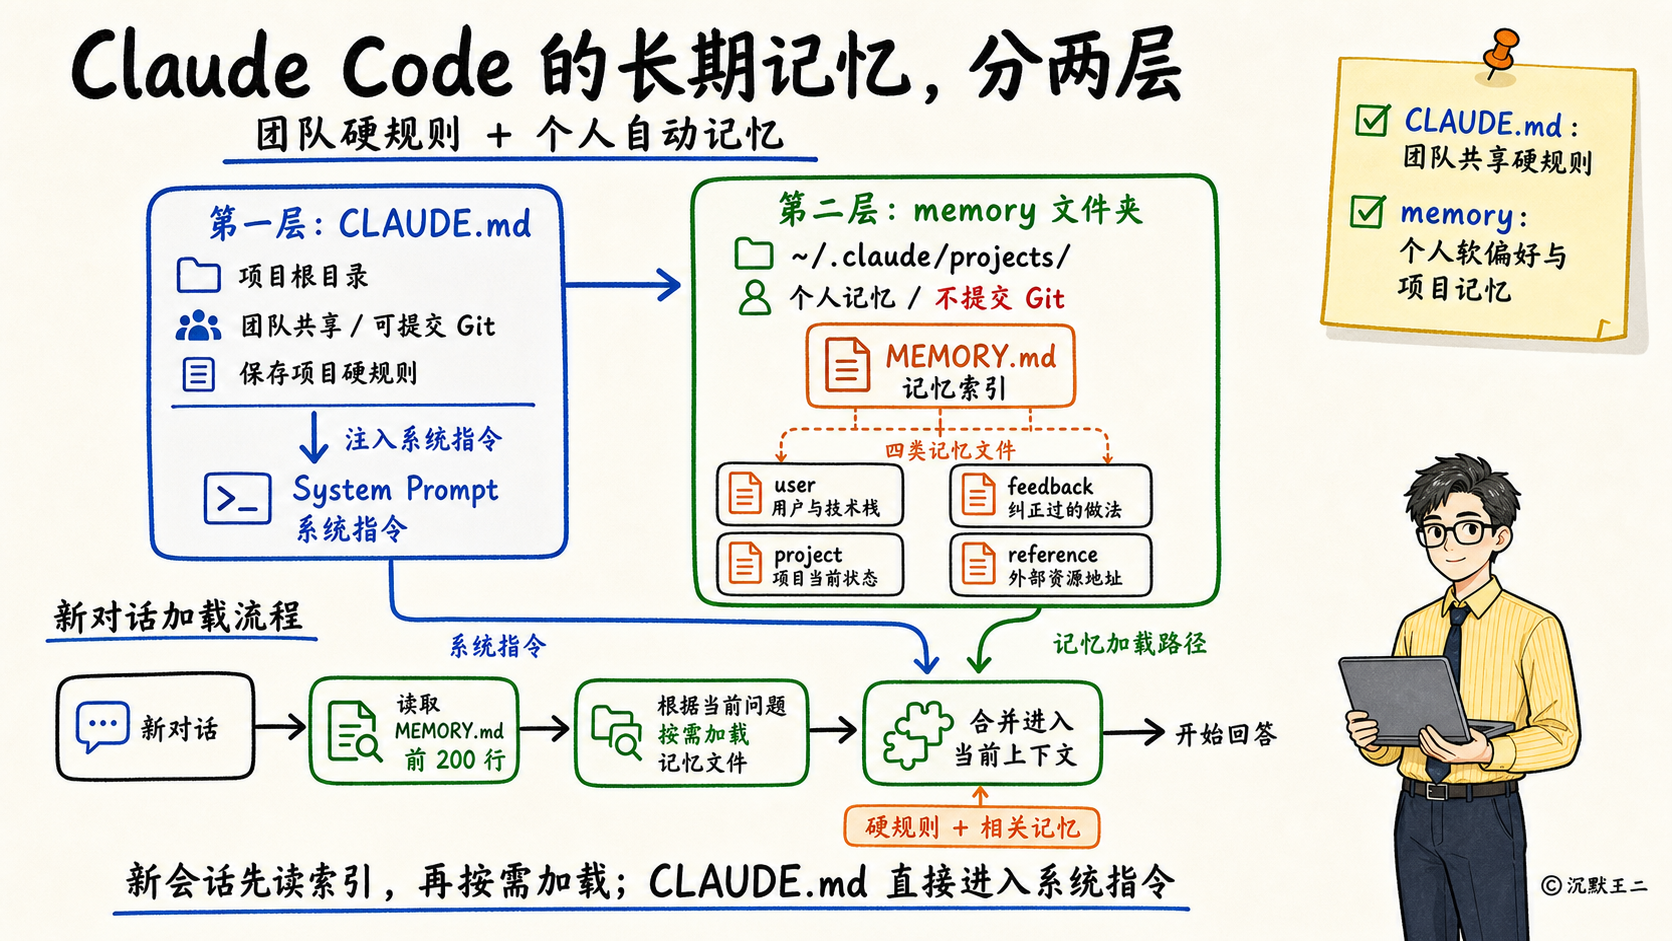
Dugoročna memorija Claude Code-a ima dva sloja.
Prvi sloj je CLAUDE.md. To je fajl sa pravilima projekta koji sam pišete, stoji u root direktorijumu projekta, može da se komituje u Git i njega deli ceo tim. Na primer, u njega napišete „koristi 4 razmaka za uvlačenje", „zabranjeno koristiti var", „baza podataka je PostgreSQL", i svaki član tima kad otvorite Claude Code može da pročita ta pravila.
Drugi sloj je memory folder. Sakriven je ispod ~/.claude/projects/, Claude Code ga pamti automatski za vas, pripada vama lično i ne ide u Git.
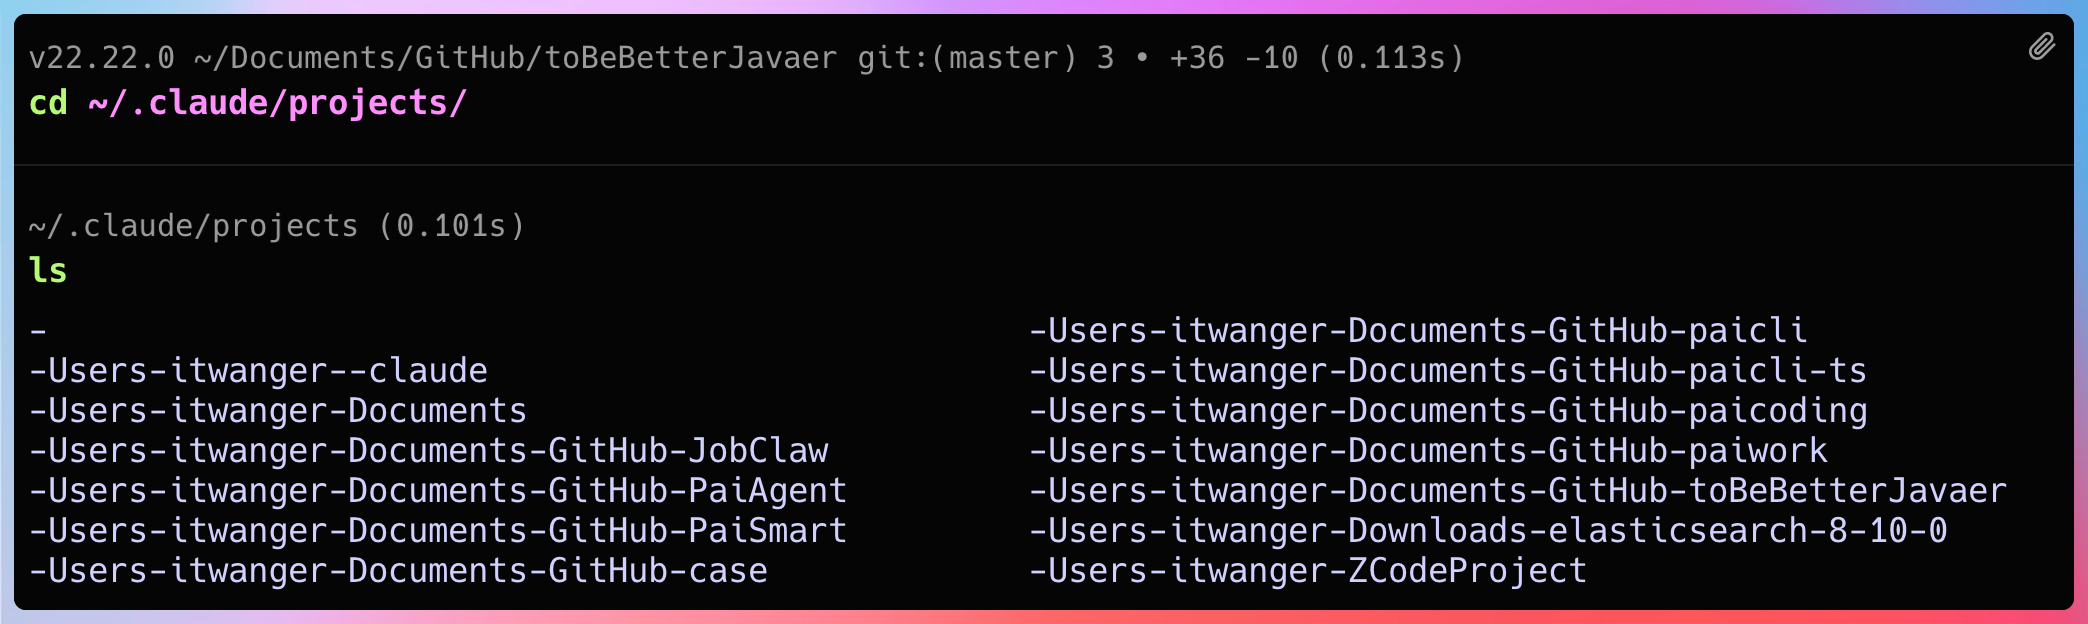
U tom folderu se nalazi jedan MEMORY.md indeks fajl, plus gomila posebnih fajlova memorije. Na početku svakog fajla memorije stoje naslov, opis i tip, a ispod je konkretan sadržaj.
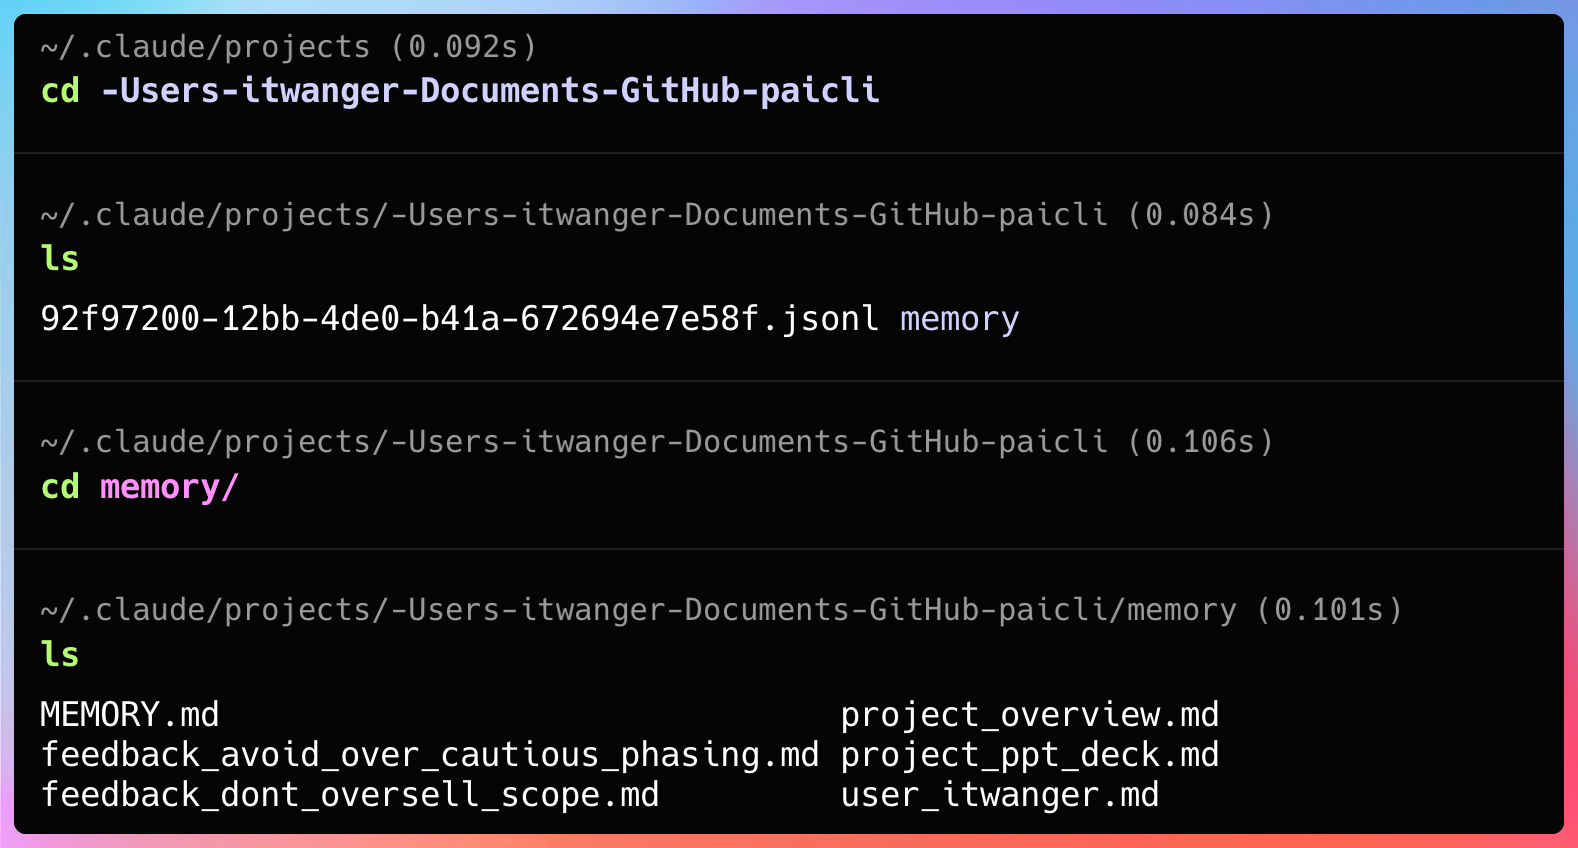
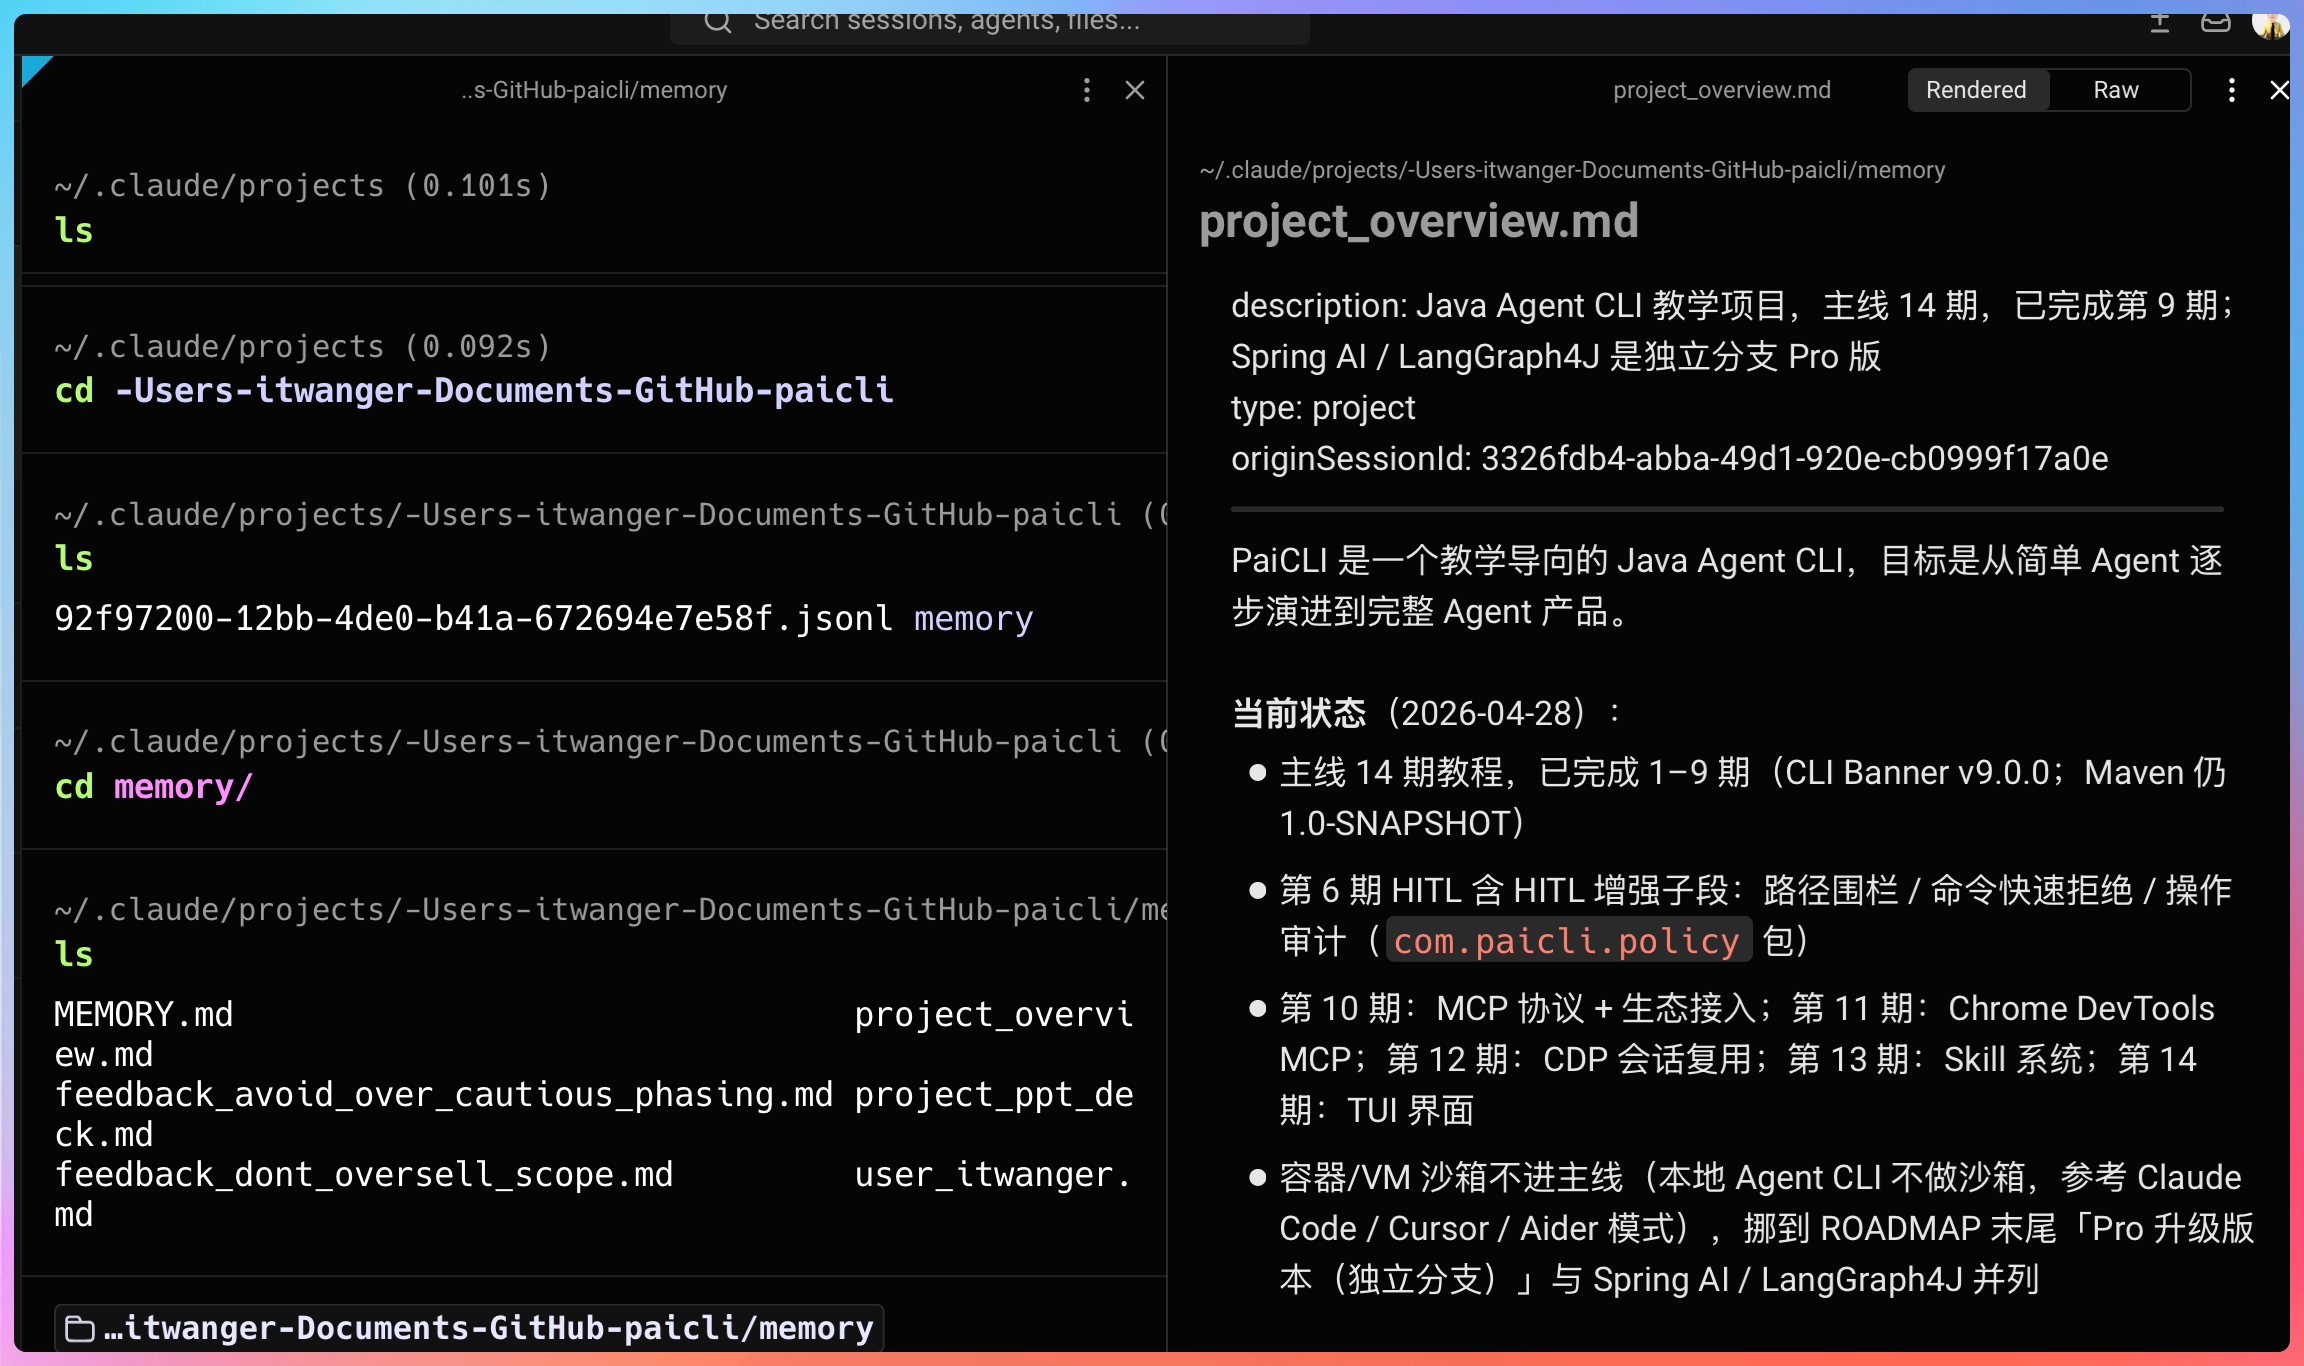
Memorija ima četiri tipa: user, beleži ko ste i koja vam je tech stack; feedback, beleži postupke koje ste ispravljali; project, beleži trenutno stanje projekta; reference, beleži adrese spoljnih resursa.
A onda ti, pametni, sigurno pomislite: kako se ova memorija uopšte sačuvava?
Na dva načina. Automatski i ručno.
Automatski: dok vi pišete kod, Claude Code sam procenjuje koje informacije vrede da se zadrže dugoročno i tiho ih sačuva za vas. Na primer, kažete „ne koristi Lombok, ovaj projekat ga ne koristi", i on automatski sačuva jednu feedback memoriju, pa kad sledeći put otvorite novi razgovor, više ti neće generisati Lombok kod.
Ručno: prosto mu kažete „zapamti: testovi idu sa JUnit 5, ne sa JUnit 4", i on odmah pamti.
Format je u oba slučaja isti — Markdown fajl sa frontmatter-om.
A onda ti, pametni, sigurno opet pitate: dobro, sačuvano je, ali kad otvorim novi razgovor, otkud on zna gde da traži?
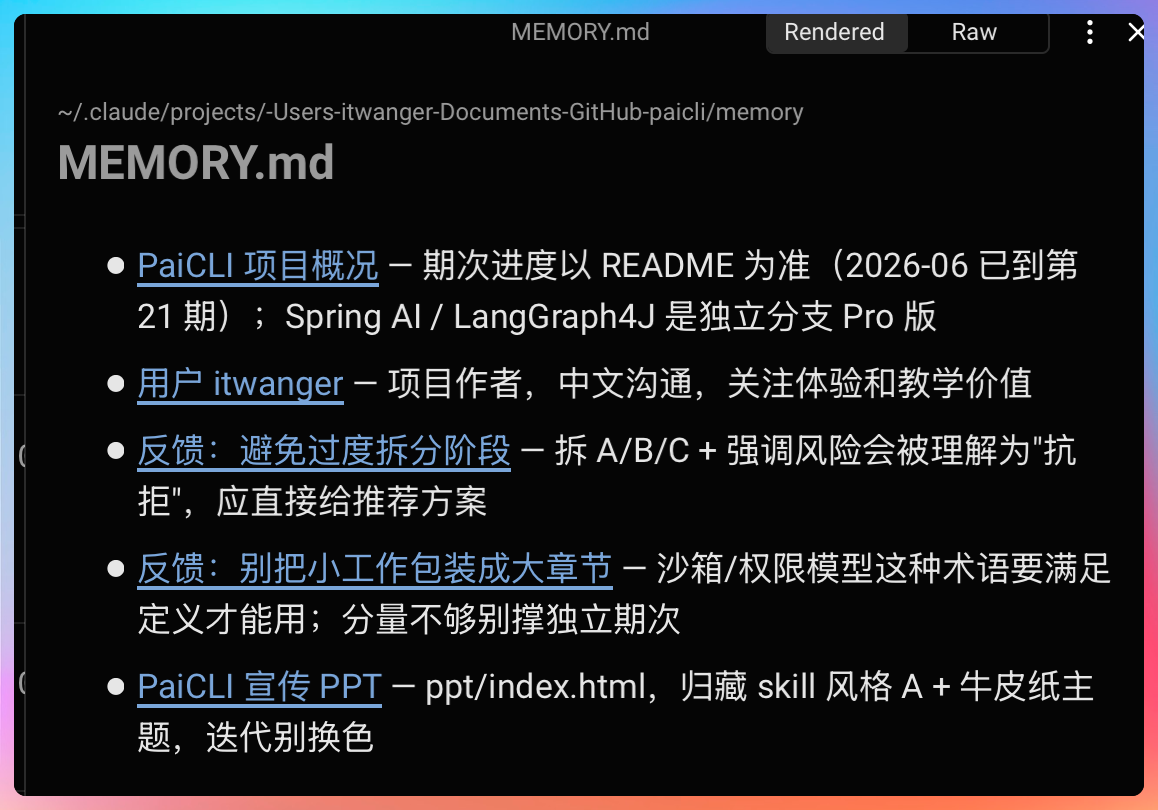
Svaki put kad se otvorite novi razgovor, Claude Code automatski ode da pročita taj indeks fajl MEMORY.md, najviše prvih 200 redova. Preko indeksa sazna koje memorije postoje, a onda po potrebi učita konkretne fajlove memorije.
CLAUDE.md je još posebniji. Ubačuje se direktno u system prompt i pri kompresiji konteksta nikad se ne odbacuje. Zato stroga pravila koja ceo tim mora da poštuje obavezno piši u CLAUDE.md. Lične, meke preferencije prepusti auto memory-ju.
Na kraju, da rezimiram.
Dugoročna memorija Claude Code-a ima dva sloja: CLAUDE.md su stroga pravila koja sam pišete, a memory folder su lične preferencije koje Claude Code pamti za vas. Još jedno: u novom projektu neka ti prva stvar bude da napišete CLAUDE.md, u njega jasno stavi tech stack, code konvencije i tabue, i uštedećete gomilu ponovljene komunikacije kasnije.
Da li ste savladali ovu temu? Za još hardcore AI znanja, lajkuj i pratipaicoding.com/stutymore/claude-code-long-term-memory-20260727163648.png)